


Markdown стає новим стандартом для всіх рівнів інфраструктури, які забезпечують роботу програм ШІ. Більше провайдерів звертаються до JSON як стандартного виводу для всього, що потрібно читати їхнім моделям, виходячи за рамки нотації об’єктів JavaScript (JSON) як стандартного універсального формату. Ця постійна зміна реальності відображає те, як навчаються великомасштабні мовні моделі, як інтерфейси чату відображають відповіді […]
Markdown стає новим стандартом для всіх рівнів інфраструктури, які забезпечують роботу програм ШІ. Більше провайдерів звертаються до JSON як стандартного виводу для всього, що потрібно читати їхнім моделям, виходячи за рамки нотації об’єктів JavaScript (JSON) як стандартного універсального формату.
Ця постійна зміна реальності відображає те, як навчаються великомасштабні мовні моделі, як інтерфейси чату відображають відповіді та як розробники фактично будують з маркерами, контекстними вікнами та витратами. І для цього усиновлення є вагома причина.
Уцінка відповідає поведінці моделі
Великі мовні моделі навчаються на великій кількості Markdown. Подумайте про сайти документації, файли README, технічні блоги, теми форумів, бази знань тощо. Це означає, що модель вже вільно володіє Markdown. Вони знають, як аналізувати заголовки, списки, таблиці та кодові зони та розглядати їх як семантичні сигнали, а не як шум.
Водночас користувальницький інтерфейс чату вже може відтворювати відповіді з Markdown. Коли модель виводить Markdown, інтерфейс може відображати це чітко без додаткових перетворень. Коли та сама модель завантажує Markdown, вона отримує інформацію у форматі, який відображає її розподіл навчання та те, як від неї очікується відповідь. Результатом є більш природний цикл введення/виведення, ніж подача моделі щільно вкладеного JSON, який потрібно подумки розпакувати перед використанням.
Уцінка також є більш скромним підходом, якщо дивитися на речі з точки зору символів. Видаліть структурні накладні витрати та збережіть корисну інформацію. Для агентів штучного інтелекту, яким потрібно вмістити велику кількість контексту в обмежене вікно, ця ефективність безпосередньо перетворюється на більш релевантний вміст за запит і нижчу вартість за висновок.
видимі тенденції
Перехід до Markdown також не є спекулятивним. Це вже закодовано в інструкціях з передового досвіду від основних постачальників моделей. Підказкова інженерна документація OpenAI чітко рекомендує структурувати повідомлення розробника за допомогою заголовків розцінок, маркованих списків і таблиць, коли це корисно. Цей посібник рекомендує використовувати «##» у основних розділах, вбудовані зворотні галочки в коді та чіткий ієрархічний формат для покращення відповідності моделі та зручності читання.
Посібники підказок сторонніх розробників повторюють той самий шаблон. Використовуйте заголовки Markdown, щоб створювати розриви розділів, списки для перерахування та таблиці для порівняння. Декілька аналізів відзначили, що Markdown є більш ефективним для маркерів і більш природним для сприйняття моделями, навченими на документації, що робить його кращим інструментом форматування для складних підказок, особливо для нових моделей серії GPT-5.
Провайдери інфраструктури погоджуються
API та постачальники даних також приваблюють Markdown. Хоча колись JSON використовувався як формат обміну загального призначення, багато JSON тепер пропонують варіанти Markdown, оптимізовані для використання з LLM. Обґрунтування точно таке ж. Ми хочемо зменшити розвантаження токенів, спростити синтаксичний аналіз агента та узгодити спосіб відображення підказок і відповідей моделі.
SerpApi – це 9-річна компанія, що розробляє API пошукових даних і нещодавно запустила вихід Markdown для всіх понад 100 API без додаткових витрат. SerpApi надає розробникам, дослідникам і компаніям зі списку Fortune 500 структуровану статистику з Google, Bing, YouTube та інших джерел. Ця функція дозволяє розробникам запитувати результати пошуку у форматі розмітки token-lite замість JSON, особливо для додатків, які працюють на основі агентів ШІ та LLM. Нова кінцева точка не потрібна; формат запитується через параметр запиту, розширення маршруту або заголовок в існуючій інтеграції.
У реальному прикладі з власних тестів SerpApi один пошук у Google за словом «кава» коштує 24 723 токенів як JSON і 6435 токенів як Markdown, що становить загальну економію 74%. У поєднанні з фільтрацією полів ця відповідь була зменшена до 1298 токенів. SerpApi повідомляє про середнє скорочення маркерів приблизно на 50% через API, а деякі кінцеві точки спостерігають скорочення до 90%.
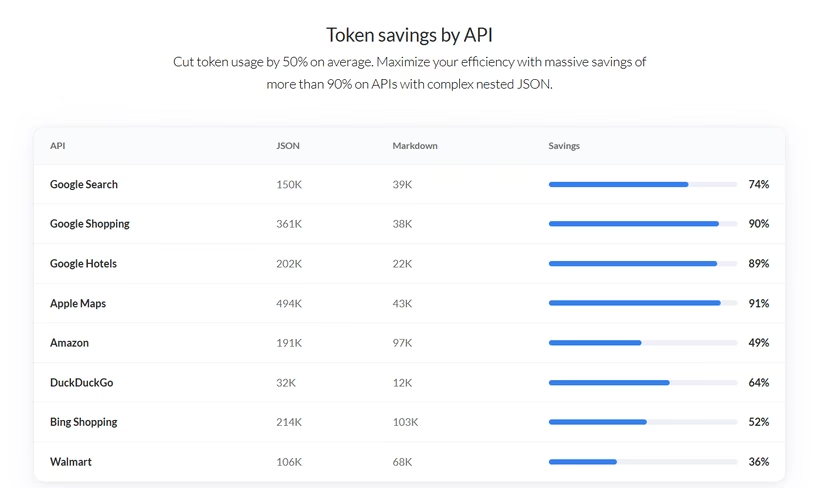
Ці цифри важливі, оскільки результати пошуку є одним із найбільш шумних і вкладених корисних навантажень, які поглинають агенти. Відповідь JSON містить посилання переспрямування, піктограми, параметри, що відстежуються, і глибоко вкладені метадані, які вашій моделі не потрібно виводити. Навпаки, виведення уцінки зберігає основну інформацію, таку як заголовки, фрагменти, посилання, ціни та рейтинги в таблицях і списках, і автоматично видаляє велику частину внутрішнього шуму відстеження та повторюваних полів.
Розробники можуть отримати доступ до нового формату Markdown, додавши «output=md» до рядка запиту, викликавши маршрут «/search.md» або встановивши заголовок «Accept: text/markdown». Відповідь включає передовий матеріал YAML для метаданих, структуровану таблицю розцінок для набору результатів і рідні вбудовані посилання, усі з яких призначені для скидання безпосередньо в підказку або пам’ять агента.
що це означає
Оскільки мережа все частіше використовується агентами, а не людьми, рівень інфраструктури буде оптимізовано для машинного читання замість зручного вкладення. У той час як JSON залишається важливим для програмних маніпуляцій і суворого дотримання схеми, Markdown з’явився як новий стандарт за замовчуванням на етапі прийому контексту робочих процесів AI.
Таким чином, у найближчі місяці ми можемо очікувати, що більше постачальників даних запропонують варіанти відповідей зі знижкою, особливо для API пошуку, електронної комерції, карт і вмісту, де ефективність маркерів безпосередньо впливає на вартість і продуктивність. Шаблони підказок і інфраструктури агентів також можуть стандартизувати розділи розмітки, таблиці та списки як стандартний спосіб представлення отриманого контексту моделям. Інструменти також повинні розвиватися навколо вимірювання та мінімізації відбитка токенів, при цьому Markdown буде основним засобом.
Для розробників, які сьогодні будують з LLM, написання на стіні. Коли ви передаєте зовнішні дані своїй моделі, вам потрібно вибрати формат, який відповідає тому, як ваша модель навчається та виводиться. Markdown більше не є просто інструментом документування. Це стає новою лінгва франка між пошуковими даними та моделями ШІ.
