

нещодавно розпечатані судові документи Нью-Йорк ТаймсПозови проти OpenAI і Microsoft є досить жахливими. Власні документи компаній попереджають, що вони починають «петлю руйнування», яка завдає шкоди мережі, характеризуючи збирання даних для навчання моделей як «найбільшу крадіжку праці в історії людства» та «повне висміювання ідеї добросовісного використання». Багато з найяскравіших цитат у документі походять від Брента Гехта, […]
нещодавно розпечатані судові документи Нью-Йорк ТаймсПозови проти OpenAI і Microsoft є досить жахливими. Власні документи компаній попереджають, що вони починають «петлю руйнування», яка завдає шкоди мережі, характеризуючи збирання даних для навчання моделей як «найбільшу крадіжку праці в історії людства» та «повне висміювання ідеї добросовісного використання».
Багато з найяскравіших цитат у документі походять від Брента Гехта, директора прикладної науки Microsoft. Однак компанія намагалася дистанціюватися від претензій Хехта. «Ці коментарі відображають погляди окремих співробітників, не є юридичним аналізом і не представляють погляди компанії», — сказав The Verge речник Microsoft Алекс Хаурек.
В окремій судовій справі Джордан Усдан, генеральний директор відділу стратегії обробки даних і операцій у Microsoft AI, охарактеризував роль Хехта як змагальну. За його словами, Гехт «має широкий спектр академічних і перспективних поглядів на те, як повинна працювати екосистема даних штучного інтелекту, і його найняла Microsoft, щоб представити асиметричну, футуристичну та академічну перспективу… він також не є тим, хто говорить від імені Microsoft щодо теоретичних поглядів на потенційний вплив ШІ на творців контенту».
Але незалежно від того, хоче чи ні Microsoft володіти цими коментарями, ясно одне: це збулося. Google Zero реальний! ШІ підриває Інтернет!
Є багато інших диких заяв NYT Подання надійшли від різних людей, у тому числі від Сатья Наделли, Сема Альтмана та інших співробітників OpenAI. Ось деякі моменти з 92-сторінкового документа.
«Шокуюча крадіжка»

У передмові цитуються Гехт і керівник ChatGPT OpenAI (імовірно Нік Терлі), ніби обидві компанії визнають, що становлять «екзистенціальну загрозу» для таких видавців, як вони. Нью-Йорк Таймс. Гехт назвав збір даних ChatGPT і Copilot «найбільшою крадіжкою робочої сили в історії людства» і сказав, що захист Microsoft «повністю висміює ідею «чесного використання»».

Сатья Наделла визнає, що чат-боти по суті замінили пошук, усунувши необхідність звертатися безпосередньо до джерела інформації. Але, мабуть, ще більшим прокляттям є цей внутрішній документ Microsoft: «Наша стратегія штучного інтелекту щодо контенту започаткувала «губну петлю», яка одночасно негативно впливає на продуктивність моделі та мережу в цілому. Дуже незвично, щоб кінцевий продукт загрожував економічній базі критично важливого постачальника, але саме таку ситуацію ми створили для нашого бізнесу LLM щодо його «ланцюга постачання вмісту».
Це навіть не реальне число

Нехай вас не обманюють твердження OpenAI або Microsoft про альтруїстичні наміри. Співзасновник OpenAI Грег Брокман більше зацікавлений у потенційних «мільярдах доларів» прибутку, які можна отримати від комерційного ШІ.

Як повідомляється, пізніше Наделла сказав: «Все, що захищено платним доступом, має бути ліцензованим», але представник OpenAI визнав, що йому «не відомо» про будь-які спроби виявити або видалити платний вміст із навчальних даних.
«Дуже добре вміє виплюнути це назад»

Внутрішньо OpenAI, схоже, добре знав про тенденцію ChatGPT просто відтворювати захищений авторським правом матеріал «як є». Співробітники визнали, що «запобігання запам’ятовуванню» є важливим для «зведення до мінімуму порушення авторських прав», але визнали, що GPT-4 «запам’ятовує великі обсяги даних і дуже добре їх повторює».
У документі також цитується кілька прикладів, коли ChatGPT виводить довгі рядки прямої копії зі статей. разів, новини ртуті, denver post, лайфхакері eurogamer У відповідь на запити.
“виправити” всю свою роботу”

Microsoft визнала, як буде сприйнято масштабне сканування Інтернету, і що «майже ніхто їх не планував». [sic] Жоден вміст не створюється для використання таким чином, і за його використання не буде отримано жодної компенсації. »
«Заміна людської праці»

Related Stories
Командори проти ковбоїв | Як дивитися, слухати та транслювати
Командори проти ковбоїв | Як дивитися, слухати та транслювати
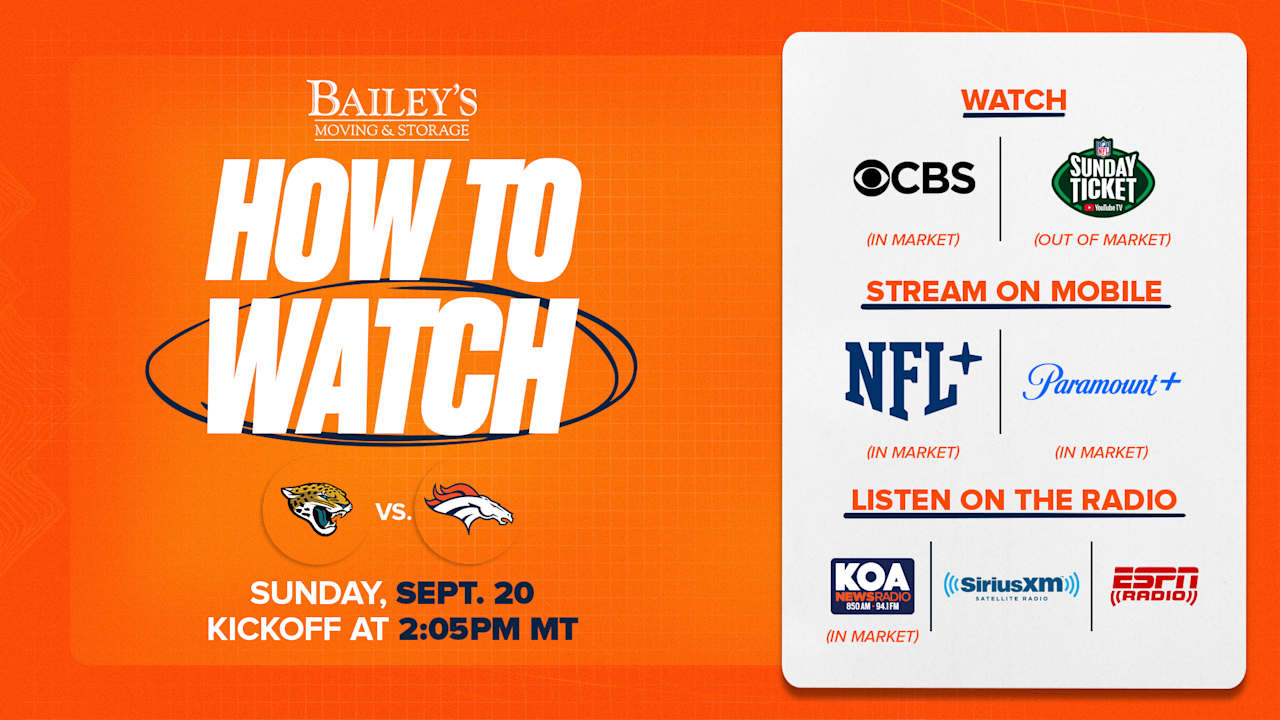
Denver Broncos проти Jacksonville Jaguars: як дивитися та транслювати гру тижня 2 Бронкос
збігатися “Бронкос” (0-1) зіграють свою першу домашню гру в сезоні на другому тижні, коли приймуть “Джексонвілл Джагуарс” (1-0).…
У справі про вбивство президента Гаїті у 2021 році заарештовано понад десяток людей
Вісімнадцять осіб були заарештовані у зв’язку з вбивством президента Гаїті Жовенеля Моіса у 2021 році, повідомили офіційні особи…